Linux 服务异常时,先检查这五件事
服务突然访问不了时,最容易走的弯路是直接重装。更有效的方法是从外到内缩小范围:机器是否在线、资源是否充足、进程是否运行、端口是否监听,最后才是应用配置。 先记录现象记下失败的地址、发生时间和报错。连接超时、连接被拒绝、HTTP 502 是不同的问题:超时可能涉及网络或防火墙;拒绝连接通常表示目标可达,但端口没有服务;502 则要继续检查反向代理与上游。 检查资源用 uptime 看负载,用 free -h 看内存,用 df -h 看磁盘。负载高不一定代表 CPU 忙,也可能是在等待磁盘。磁盘满会使数据库写入、日志和证书续期同时失败。 查看服务和日志systemd 服务可用 systemctl status 服务名 查看状态,再用 journalctl -u 服务名 --since "30 min ago" 查看近期日志。容器则检查 docker ps -a 和 docker logs --tail 100 容器名。重点找第一次失败,而不是反复出现的后续错误。 确认监听地址ss -lntp 能看到 TCP 监听端口。监听在 127.0.0.1 的服务通常只能...
日志要留下证据,也要有清理边界
访问日志、错误日志和审计记录的用途不同。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 先规划保存范围访问日志、错误日志和审计记录的用途不同。排障常常只需要近期详细日志,而长期趋势更适合聚合指标。先决定保留多久、是否压缩、是否异地保存,再配置轮转。 轮转不只是改文件名许多服务在日志文件重命名后仍持有旧句柄,需要发送信号重新打开。logrotate 的 postrotate 可以处理这一环。copytruncate 存在复制与截断之间的小窗口,不适合对日志完整性要求很高的场景。 日常使用的小结定期检查轮转是否真的发生,以及压缩文件是否占据意外空间。配置文件写好了,不代表定时任务一定运行成功。
改了 DNS 却还访问旧站,缓存到底在哪里
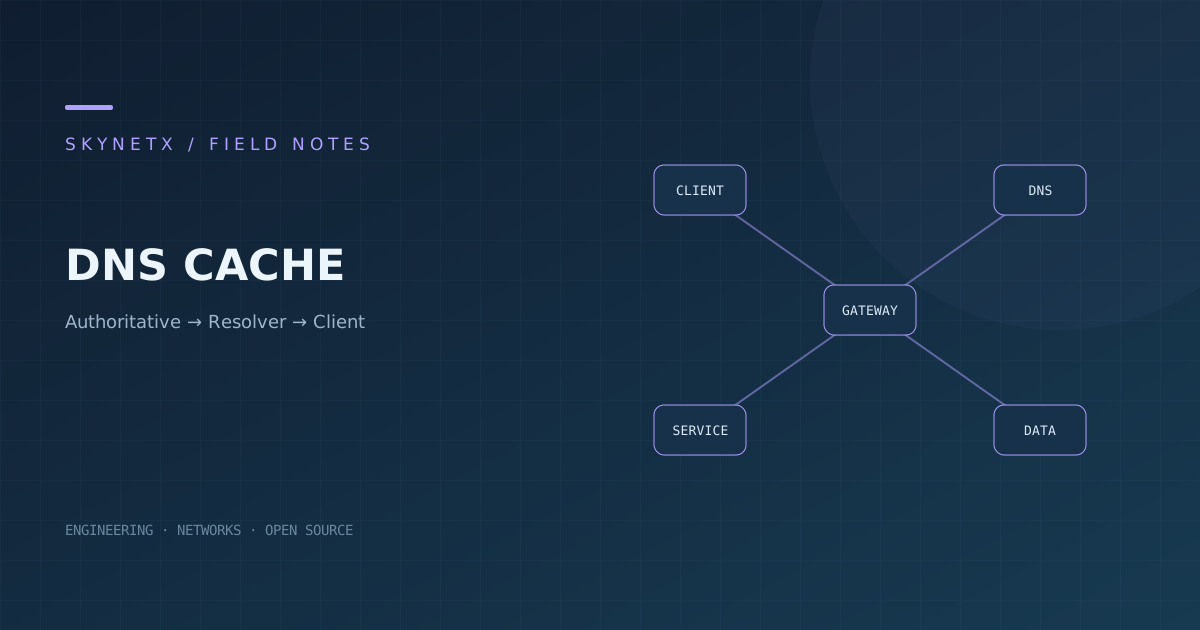
权威 DNS、递归解析器、操作系统、浏览器以及应用自身都可能缓存记录。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 不同位置有不同缓存权威 DNS、递归解析器、操作系统、浏览器以及应用自身都可能缓存记录。修改控制台中的 A 记录,不意味着所有访问者会立即看到新地址。TTL 是重要参考,但不是任意环节都能强制遵守的承诺。 分层查询比反复刷新有效先确认权威记录,再查公共递归解析结果,最后看本机查询。浏览器使用加密 DNS 时,可能绕过系统配置。用 curl 的 resolve 参数可以临时指定连接地址,同时保留正确域名与 TLS 校验。 日常使用的小结迁站时提前降低 TTL,在切换期间保留旧服务一段时间。不要因为一台设备缓存未更新,就连续修改多次解析记录。
终端工具选择:让常用操作更轻,而不是更复杂
搜索文件慢、查看日志不方便、切目录步骤太多,才是寻找工具的好起点。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 先找重复发生的摩擦搜索文件慢、查看日志不方便、切目录步骤太多,才是寻找工具的好起点。先选一项最常见的任务,试用一个工具,再决定是否纳入日常环境。 保留基础命令的理解增强工具能提高效率,但远程机器不一定装了相同软件。了解 find、grep、less 等基础命令,有助于在最小环境里工作。个人别名也应写进可查看的配置。 日常使用的小结工具越多,维护和迁移成本越高。每隔一段时间清理不再使用的插件,比不断安装新工具更能保持环境轻快。
容器显示 Up,为什么网站还是打不开
容器主进程存在时,Docker 就可能显示 Up。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 运行状态不等于业务状态容器主进程存在时,Docker 就可能显示 Up。应用可能还在初始化,也可能主进程只是一个没有退出的入口脚本。健康检查应该触及真正提供服务的路径,而不只是检查进程号。 健康检查也需要设计初始化时间较长时设置 start_period;测试命令要有超时,避免挂起。检查接口最好不依赖所有外部服务,否则外部网络短暂波动就会把容器标成异常。 日常使用的小结再补一个面向用户入口的探测,才能覆盖反向代理、证书和 DNS。容器健康与公网访问正常,是两种互补的信号。
时间差几分钟,为什么会影响登录和证书
证书有效期、短期令牌、日志关联和任务调度都依赖时钟。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 很多协议都依赖时间证书有效期、短期令牌、日志关联和任务调度都依赖时钟。系统时间偏差可能表现为登录失效或 TLS 错误,而不是直接提示时间不对。 时区与时钟是不同问题UTC 时刻正确但显示时区不符合习惯,通常属于展示设置。应先检查时间同步服务,再确认应用与数据库使用的时区。修改时区并不会修复真正的时钟漂移。 日常使用的小结排障时记录时间戳和时区,跨机器比较日志尤其如此。避免在应用运行中随意手动跳变系统时间,优先使用系统支持的同步机制。
开始使用密码管理器前,先准备恢复方案
密码管理器让每个站点使用不同密码更容易,但主密码、设备解锁与双重验证构成新的访问链路。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 主密码是新的关键入口密码管理器让每个站点使用不同密码更容易,但主密码、设备解锁与双重验证构成新的访问链路。主密码应足够强且能记住,不要仅依赖浏览器记忆。 把恢复材料单独保存恢复代码、紧急联系人和加密导出要有明确存放位置。云同步不等同于备份,账号异常或设备遗失时,需要能够独立完成恢复。共享资料也应使用工具提供的权限机制。 日常使用的小结迁移时先导入少量记录测试,确认网址匹配和自动填充正确。临时导出的明文文件完成迁移后应妥善清理。
网页能开,上传却卡住:认识 MTU 与路径探测
链路能通过的最大报文大小有限,隧道还会增加封装开销。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 数据包大小会影响路径链路能通过的最大报文大小有限,隧道还会增加封装开销。小请求正常而大传输停顿,可能与路径 MTU 发现受阻有关,但也要排除丢包、应用限制和代理超时。 不要把降低 MTU 当万能药先记录接口 MTU,检查隧道与上游网络的要求,再做受控测试。IPv4 与 IPv6 的分片机制不同,不应照搬同一条经验。必要的 ICMP 消息应正确放行,不能为了省事全部屏蔽。 日常使用的小结保留调整前的值,使用持续上传、下载等真实场景比较结果。一次只改一个接口,避免多个设备同时调整后难以定位。
Compose 升级前,先确认你将运行哪个镜像
latest 是可变化的标签,也可能指向本地旧缓存。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 标签不是固定版本latest 是可变化的标签,也可能指向本地旧缓存。更新部署文件或重建容器,并不必然下载新镜像。需要先 pull,再核对版本或 digest,并记录升级前实际使用的镜像。 应用与数据要分别回滚保留旧镜像只能回退程序。新版本如果升级了数据库结构,旧程序可能无法读取数据。因此升级前应阅读迁移说明,并建立一致性备份。重要应用可以先在隔离环境测试恢复。 日常使用的小结一次只升级一个关键组件,确认健康检查与真实业务请求后再继续。不要把镜像清理和版本升级同时进行,免得刚升级就失去回退机会。
SQLite 的 WAL 文件,为什么不能随手删
WAL 模式把新事务追加到日志,再在合适的时候 checkpoint 回主数据库。本文整理两个容易忽略的环节,作为日常使用时的检查参考。 WAL 是写入流程的一部分WAL 模式把新事务追加到日志,再在合适的时候 checkpoint 回主数据库。数据库文件和 WAL 的体积变化,并不一定代表异常。仍有活动连接时,手动删除 WAL 可能破坏正常工作。 备份要使用一致性方式可以使用 SQLite backup API 或 sqlite3 的备份能力,也可以在应用完全停写后整体复制相关文件。不要只复制主数据库文件,就假定获得了最新的完整数据。 日常使用的小结长期存在大 WAL 时,应检查长事务、连接管理与 checkpoint 策略。先理解谁在读写,再决定是否调整数据库参数。